
Introducción
Escalar la infraestructura de observabilidad en Kubernetes no es solo un problema de software, es un desafío de ingeniería de recursos. Cuando los equipos de DevOps migran de logs en texto plano a logs estructurados con decenas de campos, el perfil de consumo de las herramientas tradicionales cambia drásticamente. La elección entre VictoriaLogs, Grafana Loki, Elasticsearch, OpenSearch, SigNoz o ClickStack define no solo la velocidad de consulta, sino el tamaño del clúster de Kubernetes necesario para sostener la ingesta.
El problema concreto radica en que los benchmarks de marketing suelen omitir los costos ocultos de la ingesta sostenida. Un sistema puede aceptar millones de líneas por segundo, pero si consume el 90% de la CPU o exige discos NVMe de alto rendimiento, su costo operativo se vuelve prohibitivo para cargas de trabajo de alto volumen. Este análisis desglosa un benchmark reciente realizado en GCP para determinar qué plataforma ofrece el mejor equilibrio entre capacidad de ingesta y eficiencia de recursos en entornos de producción reales.
Qué ocurrió
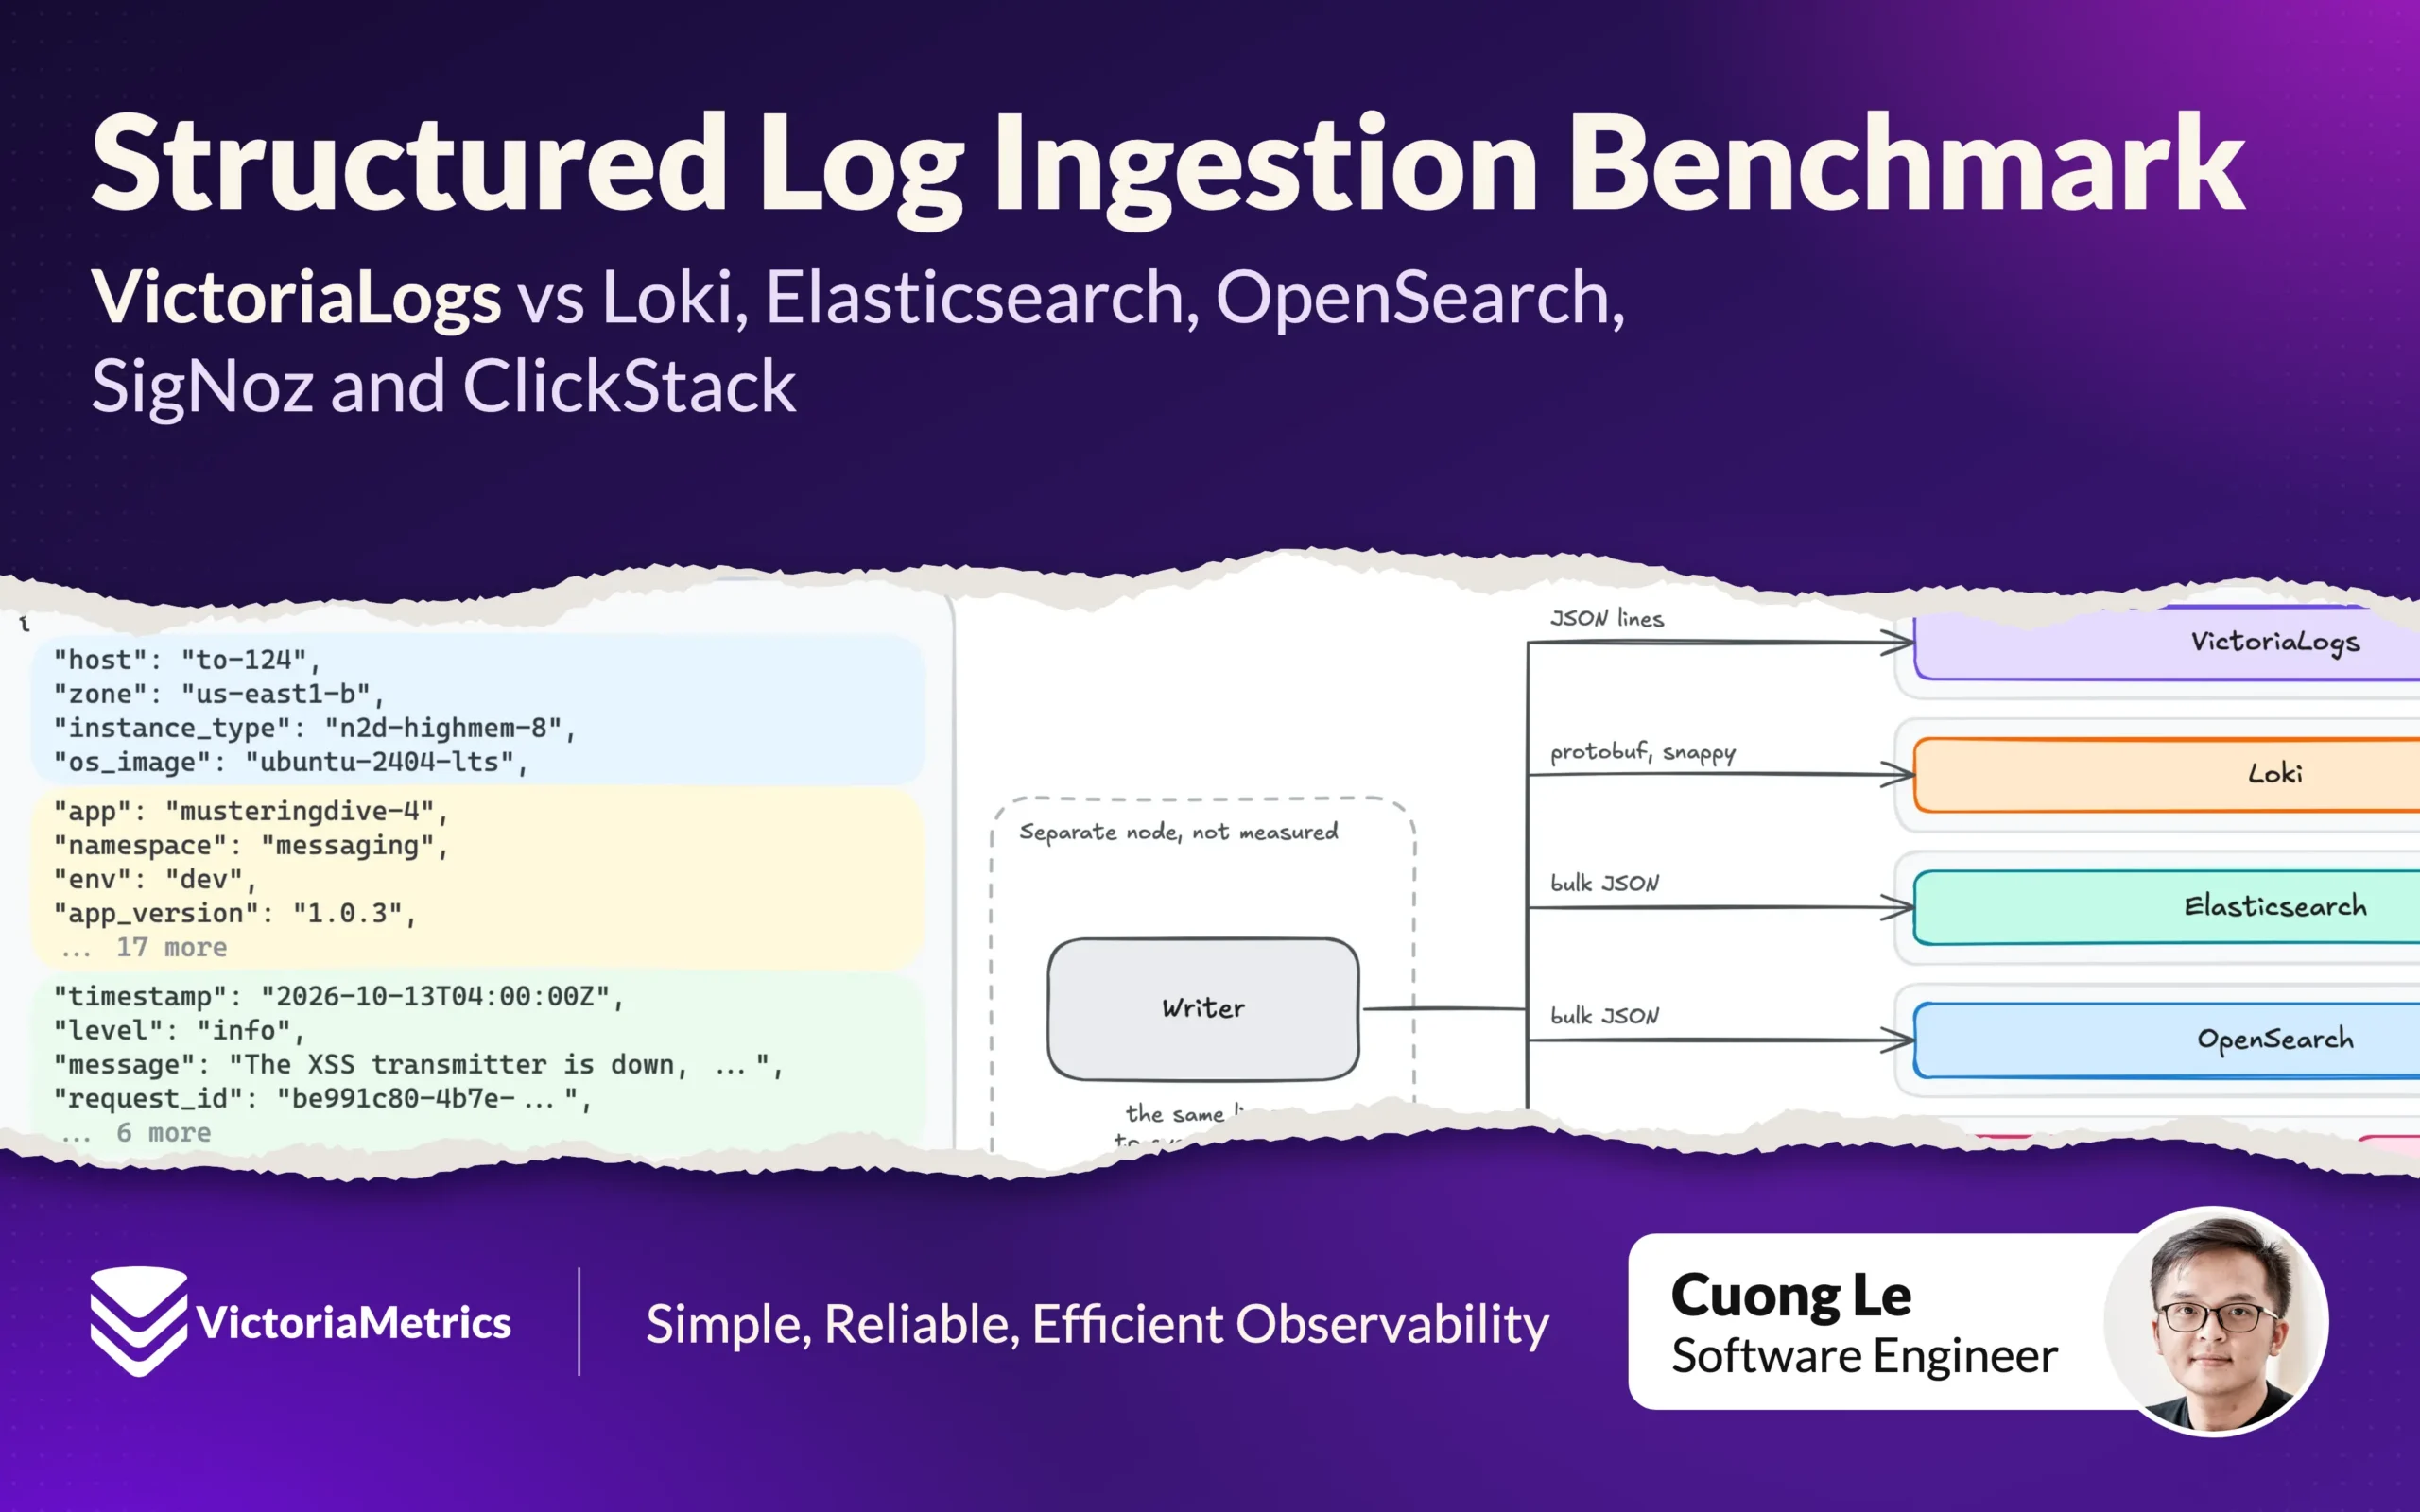
VictoriaMetrics publicó un benchmark exhaustivo comparando seis sistemas de logs en un entorno controlado de Kubernetes. El objetivo no fue declarar un ganador absoluto, sino exponer los límites de diseño de cada arquitectura bajo condiciones idénticas de hardware. Se configuraron nodos n2d-standard-8 de GCP (8 vCPUs, 32 GB RAM) para cada sistema, enviando el mismo volumen de logs estructurados a todos simultáneamente.
La prueba simuló un entorno de Kubernetes mediano de 125 nodos, generando aproximadamente 5.000 streams de logs únicos. Las líneas de log contenían entre 30 y 40 campos, representativos de una aplicación típica en Kubernetes que incluye metadatos del pod, namespace y etiquetas del log shipper. La tasa de ingesta comenzó en 10.000 líneas por segundo y aumentó en incrementos de 10.000 cada 10 minutos hasta alcanzar el punto de fallo del sistema. Se midieron la tasa máxima de ingesta sostenida, el consumo de CPU, la memoria pico y el espacio en disco requerido.
Impacto para DevOps / Infraestructura / Cloud / Seguridad
Para los equipos de plataforma, estos resultados traducen directamente en costos de infraestructura en la nube. En un escenario de retención de 30 días a una tasa moderada de 50.000 líneas por segundo, la diferencia en almacenamiento es abismal: VictoriaLogs requiere aproximadamente 7 TiB, Grafana Loki necesita 12 TiB y Elasticsearch llega a 33 TiB. Esta disparidad impacta directamente en la factura de almacenamiento (S3, GCS o EBS) y en los tiempos de recuperación ante desastres.
Desde la perspectiva de seguridad y estabilidad, la ingesta de logs en formato JSON nativo presenta riesgos de rendimiento en algunos sistemas. Loki, por ejemplo, sufre una degradación significativa cuando recibe JSON en lugar de su formato binario Protobuf, cayendo de ~120k líneas/s a ~99k líneas/s. Esto obliga a los equipos a introducir capas adicionales de conversión o a estandarizar agresivamente sus log shippers (como Grafana Alloy o Vector), lo que aumenta la complejidad operativa y los puntos únicos de fallo si esos shippers se saturan.
Detalles técnicos
El benchmark reveló que la CPU es el cuello de botella principal para la mayoría de los sistemas en configuración de nodo único. VictoriaLogs demostró ser el más eficiente, manteniendo un consumo de CPU inferior incluso a tasas de ingesta elevadas, gracias a su arquitectura de compresión de campos individuales. En contraste, Loki alcanza tasas de ingesta muy altas (superior a 120k líneas/s con Protobuf) porque no indexa cada campo individualmente, sino que almacena la línea cruda y solo indexa las etiquetas del stream.
Esta decisión de diseño de Loki tiene dos consecuencias técnicas críticas. Primero, el consumo de memoria escala linealmente con el número de streams activos, ya que mantiene los datos recientes en memoria para compresión. En entornos Kubernetes con despliegues frecuentes, el número de streams se dispara, provocando picos de memoria que pueden causar OOM kills. Segundo, el volumen de escritura en disco (write amplification) es significativamente mayor. Loki escribe entre 3x y 7x más datos por línea que VictoriaLogs debido a la menor eficiencia de compresión de texto crudo frente a campos estructurados.
SigNoz y ClickStack, basados en ClickHouse, requieren un colector OpenTelemetry en el mismo nodo para recibir logs, ya que ClickHouse no acepta ingesta directa de shippers. Esto agrega una capa de procesamiento de CPU y memoria que compite con el motor de base de datos. En las pruebas, la estabilidad del colector fue un factor limitante, afectando la confiabilidad de la ingesta medida. Elasticsearch y OpenSearch mostraron consumos de CPU y disco consistentemente altos, reflejando el costo de mantener índices invertidos completos para cada campo.
Qué deberían hacer los administradores y equipos técnicos
Si tu arquitectura actual depende de Elasticsearch o OpenSearch y enfrentas costos elevados de almacenamiento, evalúa una migración escalonada a VictoriaLogs para los logs estructurados, manteniendo Elasticsearch solo para casos de uso que requieran búsqueda de texto completo compleja (full-text search) o análisis faceta avanzado. La reducción de 33 TiB a 7 TiB en el ejemplo de 30 días justifica el esfuerzo de migración en la mayoría de los escenarios de alto volumen.
Para los equipos que utilizan Grafana Loki, la optimización inmediata pasa por el formato de ingesta. Asegúrate de que tus log shippers estén configurados para enviar Protobuf en lugar de JSON. Si utilizas Fluent Bit o Fluentd, verifica que estén emitiendo en formato logproto. Si no es posible cambiar el shipper, considera introducir Grafana Alloy como agente de ingesta intermedio para convertir JSON a Protobuf antes de enviar a Loki. Esto puede mejorar la tasa de ingesta hasta un 20% sin cambios de hardware.
# Ejemplo de configuración en Grafana Alloy para convertir a Protobuf
loki.write "default" {
  endpoint {
    url = "http://loki:3100/loki/api/v1/push"
  }
  compress_config {
    encoding = "gzip"
  }
}
Monitorea activamente el número de streams de logs en Loki. Configura alertas cuando el conteo de streams únicos supere los límites recomendados para tu memoria disponible. En Kubernetes, esto suele ocurrir durante rollouts masivos donde cada pod nuevo genera un stream único. Implementa estrategias de etiquetado que reduzcan la cardinalidad, agrupando pods por deployment en lugar de por nombre individual siempre que sea posible.
Conclusión
No existe una solución universal para la ingesta de logs estructurados en Kubernetes. VictoriaLogs ofrece la mejor eficiencia en recursos (CPU y disco) para cargas de trabajo de alto volumen con consultas basadas en campos estructurados. Grafana Loki sigue siendo competitivo en ingesta pura si se optimiza el formato de envío, pero sufre en entornos de alta cardinalidad y consume más almacenamiento. Elasticsearch y OpenSearch permanecen como opciones válidas para búsquedas complejas, pero su costo de infraestructura es difícilmente justificable para logs operativos rutinarios.
La decisión final debe basarse en tu perfil de consulta y tu presupuesto de hardware. Si priorizas el costo de almacenamiento y la eficiencia de ingesta, VictoriaLogs es la opción técnica sólida. Si tu equipo ya está profundamente integrado en el ecosistema Grafana y tiene control sobre los shippers, Loki es viable con optimizaciones específicas. Evalúa tu volumen actual y proyectado antes de comprometerse con una plataforma a largo plazo.
Fuentes
https://victoriametrics.com/blog/structured-log-ingestion-benchmark/